Quand une couche intermédiaire devient-elle utile ?
Une connexion directe convient lorsque deux applications échangent quelques données avec des règles stables. Lorsque plusieurs logiciels doivent communiquer, une couche intermédiaire peut centraliser les transformations, l’authentification, les règles de correspondance, la gestion des erreurs et la supervision.
Cette architecture facilite l’évolution d’un ERP ou d’un CRM lorsque plusieurs applications dépendent déjà de leurs données. Le choix dépend du nombre de systèmes, des volumes, de l’importance des opérations et de la fréquence des changements.
Peut-on reprendre des intégrations déjà en production ?
Une entreprise peut accumuler scripts, imports automatisés, webhooks, tâches planifiées et connecteurs développés par plusieurs prestataires. Nous commençons par identifier les composants, les applications reliées, les données échangées et les dépendances réellement utilisées.
Les éléments fiables peuvent être conservés, tandis que les points fragiles sont progressivement documentés, sécurisés ou remplacés. La reprise peut inclure les dépôts de code, accès, secrets, environnements, journaux et procédures d’intervention.
Comment concevoir une intégration fiable ?
Nous définissons d’abord le système responsable de chaque donnée. Une même information peut apparaître dans plusieurs logiciels, mais une application doit rester responsable de sa valeur de référence. Nous précisons donc qui crée, qui modifie et qui consulte chaque donnée afin d’éviter les informations contradictoires.
Nous cadrons ensuite le moment de synchronisation, les règles de correspondance, les transformations, les contrôles et la reprise après erreur. Un paiement peut être transmis immédiatement par webhook, tandis qu’une consolidation comptable peut être traitée chaque nuit.
API REST, GraphQL, webhooks ou traitements planifiés ?
Le mécanisme dépend des systèmes disponibles, de la fréquence des échanges et de la criticité des opérations. REST convient à de nombreux échanges applicatifs, GraphQL répond à des besoins de consultation variables, un webhook transmet rapidement un événement et un traitement planifié convient mieux aux imports volumineux, historiques ou consolidations.
Des fichiers structurés, SFTP ou files de messages peuvent compléter l’architecture lorsque les logiciels historiques, les partenaires ou les volumes l’exigent. Nous retenons le mécanisme adapté au fonctionnement réel du système plutôt qu’une architecture plus complexe que nécessaire.
Comment gérer les erreurs et les doublons ?
Une API peut ralentir, refuser une requête, atteindre une limite ou devenir temporairement indisponible. Selon la criticité, nous pouvons prévoir des timeouts, tentatives automatiques, temporisation progressive, files d’attente, alertes et procédures de reprise afin qu’une opération importante reste identifiable et récupérable.
Des identifiants uniques, des clés d’idempotence et des identifiants de corrélation permettent d’éviter qu’une commande, un paiement ou une facture soit créé deux fois lorsqu’une réponse tarde et qu’une nouvelle tentative est déclenchée.
Comment sécuriser et superviser les échanges ?
Les méthodes d’accès sont choisies selon les systèmes concernés et la sensibilité des données. Une intégration peut utiliser OAuth 2.0, OpenID Connect, JWT, clés API, certificats, signatures de webhooks ou authentification mutuelle TLS. Les comptes techniques reçoivent uniquement les autorisations nécessaires et les secrets sont stockés dans des espaces adaptés.
Les journaux structurés, métriques, alertes et tableaux de suivi doivent permettre de retrouver l’opération envoyée, l’application concernée, le résultat, le nombre de tentatives et la donnée ayant provoqué un rejet. Cette information rend l’intervention plus rapide et facilite la maintenance.
Peut-on connecter un ancien logiciel ?
Oui, lorsque le logiciel met à disposition une interface exploitable. Selon l’environnement, l’intégration peut utiliser CSV, XML, JSON, SFTP, base de données, fichiers intermédiaires, service existant ou mécanisme fourni par l’éditeur. Nous vérifions d’abord les possibilités officiellement disponibles afin de construire une connexion compatible avec les futures mises à jour.
Une couche intermédiaire peut convertir les données vers un format plus simple à exploiter par les autres applications, sans contourner un mécanisme de sécurité ni dépendre d’une manipulation fragile.
Comment se déroule un projet d’intégration API ?
01 - Cadrage
Cartographie des applications, données et responsabilités.
02 - Architecture
Définition des API, règles de synchronisation et contrôles.
03 - Développement et tests
Réalisation des connecteurs, tests de sécurité et gestion des erreurs.
04 - Mise en production
Déploiement, supervision, documentation et accompagnement.
Des intégrations maintenues dans la durée
Les API des éditeurs évoluent : une méthode d’authentification peut changer, une version peut être retirée, de nouveaux champs peuvent apparaître ou certains quotas peuvent être modifiés. Koragence peut intégrer la maintenance des connecteurs à une prestation de TMA ou de maintenance applicative, avec suivi des dépendances, corrections, tests et adaptation aux nouvelles versions.
Cette continuité est particulièrement importante lorsque l’intégration participe à la prise de commande, à la facturation, au paiement, à la production ou à une autre opération essentielle de l’entreprise.
Quand faire appel à une agence d’intégration API ?
Une prestation devient pertinente lorsque vos équipes ressaisissent les mêmes informations, que des exports Excel ou CSV transmettent encore des données importantes, que votre CRM et votre ERP contiennent des informations contradictoires, ou qu’un portail doit récupérer automatiquement les données de vos outils internes.
Elle est également utile lorsque plusieurs API tierces participent au fonctionnement de votre produit, que vos connecteurs génèrent des erreurs difficiles à retrouver ou qu’un changement d’ERP, de CRM ou d’éditeur impose de reprendre plusieurs échanges.
Agence d’intégration API ou plateforme no-code ?
Make, n8n, Zapier et les plateformes iPaaS sont adaptés lorsque les applications disposent déjà de connecteurs fiables et que les règles restent simples. Le développement spécifique devient pertinent pour des règles métier particulières, des volumes importants, des exigences de sécurité, des API propriétaires ou une gestion complexe des erreurs.
L’approche peut associer les deux modèles : une plateforme existante pour les automatisations simples et des composants développés sur mesure lorsque le contrôle, la traçabilité ou la résilience deviennent essentiels.
Quel budget prévoir ?
Le budget dépend du nombre d’applications, des opérations à synchroniser, de la qualité des API, du sens des échanges, des transformations, des volumes, de la sécurité, de la supervision et des cas d’erreur à prendre en charge. Une connexion simple entre deux services bien documentés demande beaucoup moins de travail qu’une synchronisation bidirectionnelle entre plusieurs systèmes historiques.
Le cadrage permet de distinguer les connexions prioritaires, les risques techniques et la maintenance à prévoir avant de chiffrer le développement.

 Onctuo
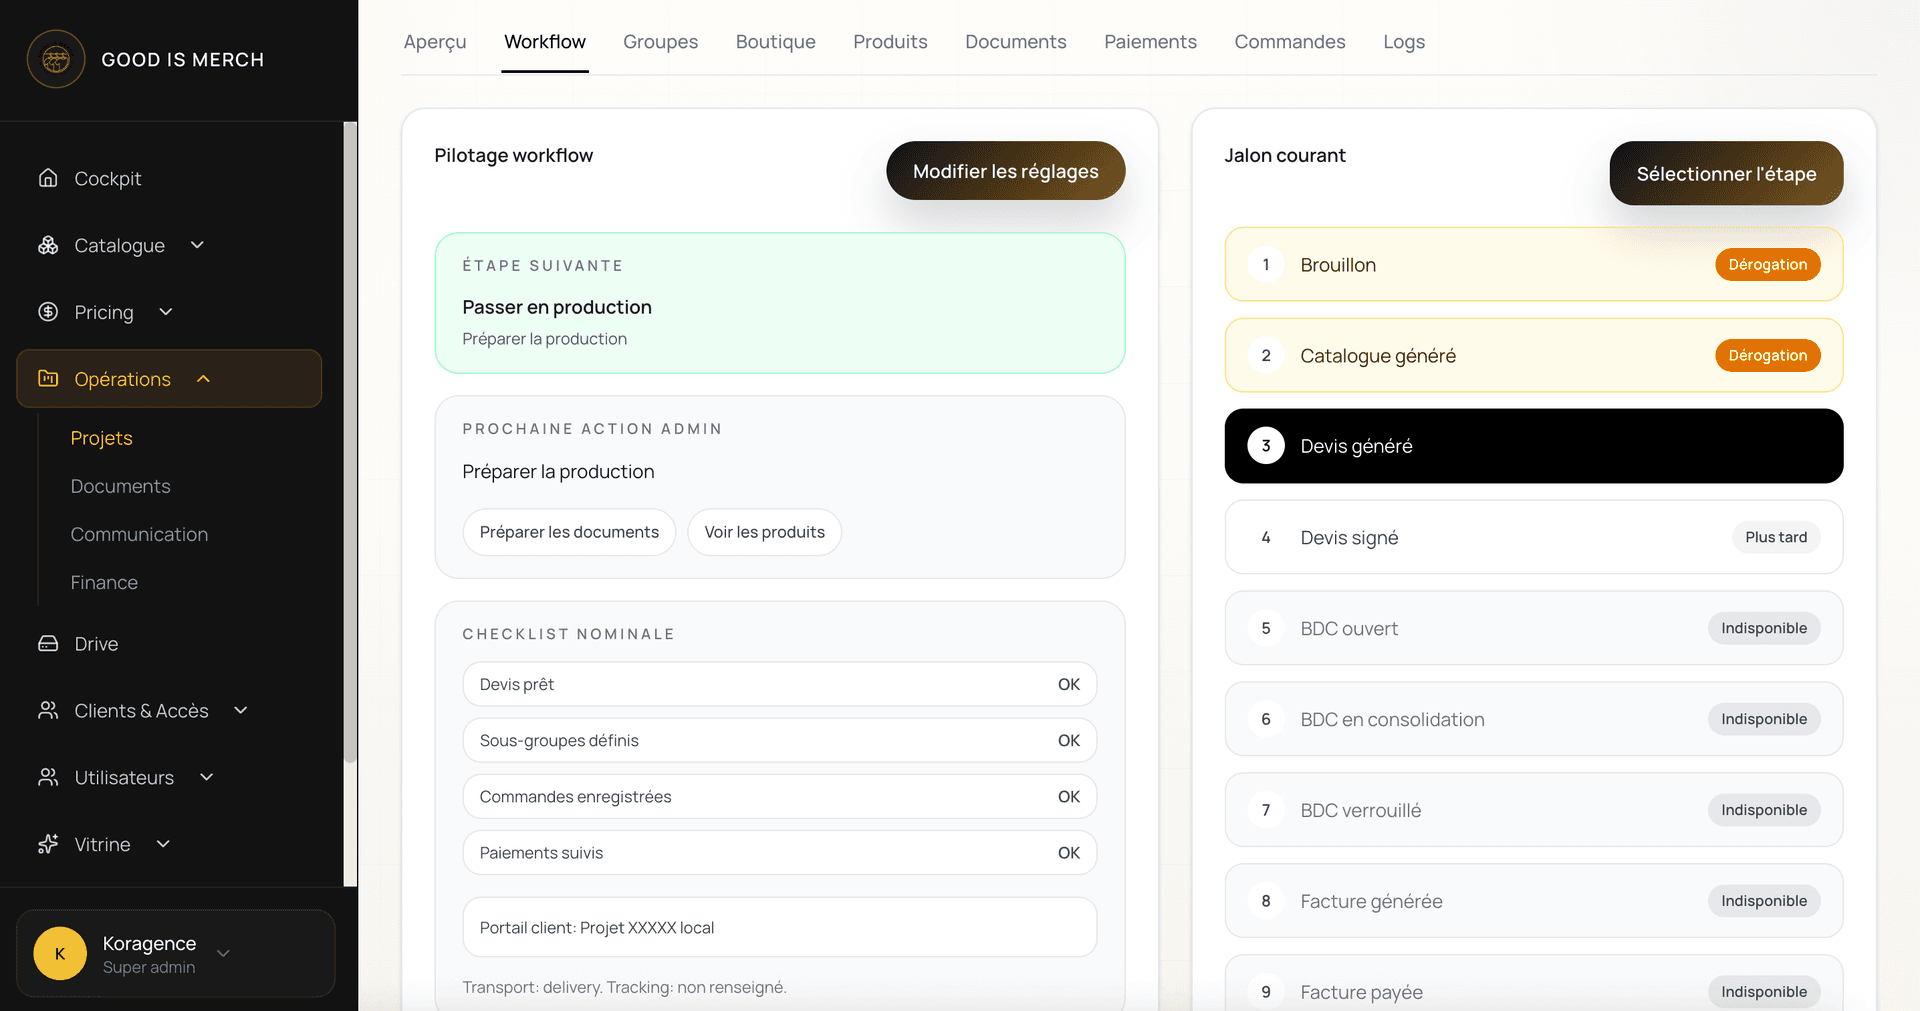
 Good is Merch
Comment concevoir une intégration fiable ?
Nous définissons d’abord le système responsable de chaque donnée. Une même information peut apparaître dans plusieurs logiciels, mais une application doit rester responsable de sa valeur de référence. Nous précisons donc qui crée, qui modifie et qui consulte chaque donnée afin d’éviter les informations contradictoires.
Nous cadrons ensuite le moment de synchronisation, les règles de correspondance, les transformations, les contrôles et la reprise après erreur. Un paiement peut être transmis immédiatement par webhook, tandis qu’une consolidation comptable peut être traitée chaque nuit.